Imaginons une étudiante en master qui rend un mémoire écrit seule, à la main, relu par sa mère. Un enseignant, un jour, le passe dans un détecteur de filigrane. Score : « probablement généré ». Elle n'a rien à produire pour se défendre, puisque la marque, par construction, ne se voit pas. C'est un cas fictif, mais le chiffre qui le rend possible est réel : OpenAI revendique 1 % de faux positifs. Sur 10 000 textes humains, une centaine d'accusés à tort.
Depuis le 5 octobre, OpenAI glisse textGrain dans les sorties de ChatGPT et Codex générées dans l'Union européenne (UE). Le filigrane est statistique : aucune mention, aucun caractère caché, mais un détecteur qui détient la clé peut estimer qu'un passage sort d'un modèle. OpenAI présente le tout comme une mise en conformité avec l'article 50 du règlement européen sur l'intelligence artificielle (AI Act).
Une encre qui ne se lit qu'avec la bonne lampe
Au moment d'écrire, le modèle penche très légèrement vers certains mots plutôt que d'autres, selon une clé secrète. Le lecteur ne remarque rien. Copié-collé, le texte garde le signal ; retapé à la main, il en garde beaucoup moins. Dans son annonce, OpenAI précise que le signal n'est lié à aucune personne, organisation, requête ou conversation.
Côté performances, OpenAI annonce 80 % de détection sur 200 tokens (un token est un fragment de mot, d'où environ 150 mots) et 95 % sur 400. Ces résultats viennent de tests internes sur des textes rédactionnels courants. Aucun tiers ne les a reproduits : le détecteur n'est ouvert qu'à des chercheurs et organisations approuvés, sur candidature. Et il ne répond qu'à une question : ce passage contient-il le signal d'un modèle d'OpenAI ? Qui a écrit, avec quelle consigne, il l'ignore.
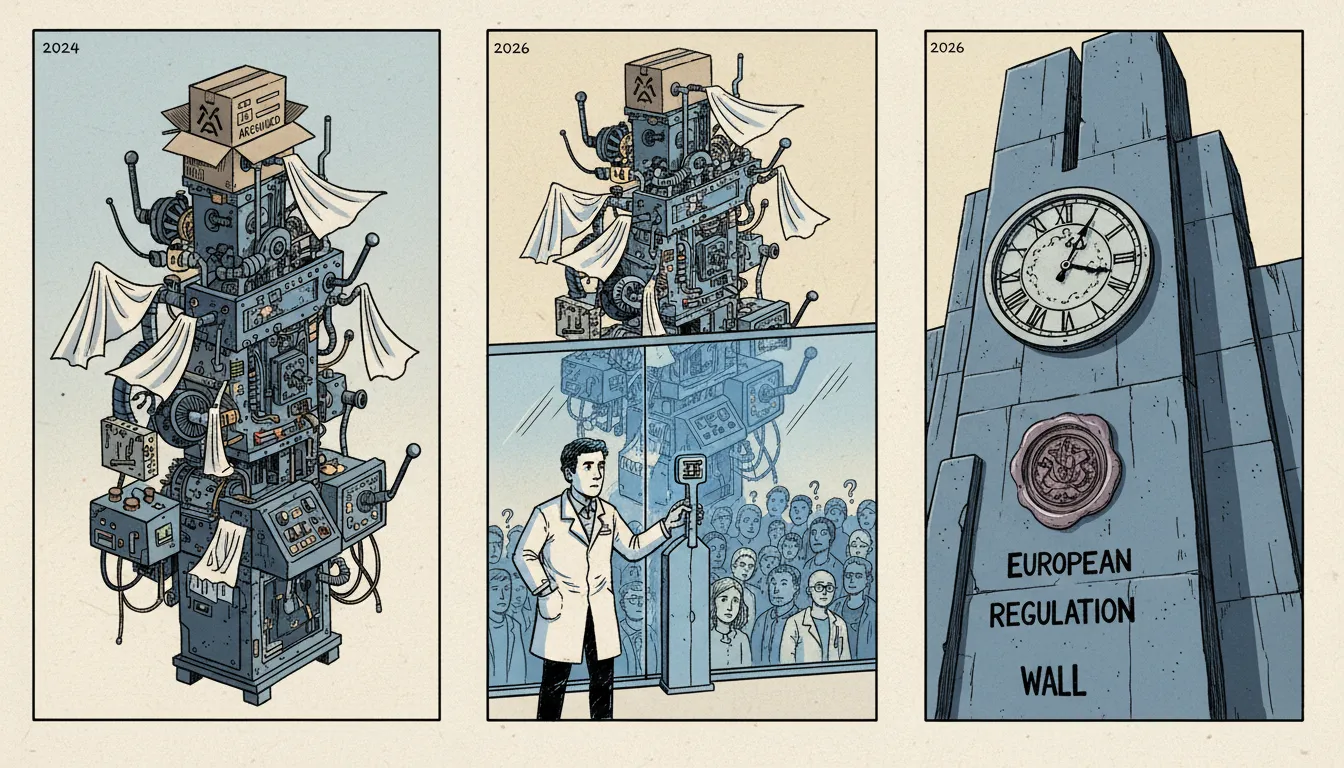
L'entreprise connaît le sujet depuis longtemps. Elle avait mis au point un procédé comparable en 2024, puis renoncé à le déployer, selon le Wall Street Journal, de peur de dégrader ses réponses et de perdre des utilisateurs. Ce qui a changé depuis tient au calendrier réglementaire, pas à la technique.
Chacun son filigrane, personne la même clé
Google a introduit SynthID-Text dans l'application Gemini dès mai 2024. Anthropic applique depuis août 2026 une variante de cette technique à Claude, dans le monde entier, selon son annonce, y compris via AWS, Google Cloud et Microsoft Foundry. Pour Gemini, la documentation officielle reste floue sur l'interface de programmation (API).
OpenAI, lui, marque automatiquement les sorties éligibles dans l'UE, tous abonnements confondus, « dans les semaines à venir » : la formule laisse ouverte la date réelle, et on n'a pas pu vérifier à quel moment chaque utilisateur est concerné. Hors d'Europe, le marquage de l'API reste sur option. Copilot, Mistral et Meta AI n'ont aucun filigrane textuel documenté, alors même qu'ils ont signé le code de bonnes pratiques européen. Les systèmes déjà commercialisés avant août ont jusqu'au 2 décembre 2026 pour s'y conformer, ce qui laisse un sursis.
L'AI Act impose le marquage, pas un détecteur public. Les fournisseurs peuvent donc se déclarer en règle tout en gardant la clé de lecture. Autorités, certains médias et laboratoires y ont accès ; l'internaute, non. Le filigrane sert d'abord à protéger ceux qui le posent : une case cochée devant le régulateur, plus qu'un outil pour le public. Les arguments ne manquent pas : aucun audit indépendant, aucun accès ouvert, aucune obligation de publier les erreurs. Reste à voir ce que la Commission européenne en dira ; on n'a trouvé, à ce jour, aucune prise de position de sa part sur la lisibilité de ces marques.
Cent accusés pour dix mille innocents
Un web qui publie des millions de textes par jour n'a que faire d'un taux de 1 %. Ouvrir le détecteur à tous reviendrait à distribuer des accusations probabilistes : à des étudiants, à des pigistes, à des indépendants. OpenAI le sait, et déconseille d'employer l'outil pour juger des copies ou des mémoires. L'accès reste fermé.
Fermé, il pose un autre problème. Un éditeur ne peut pas démontrer qu'un texte n'a pas été généré. Le fournisseur peut affirmer que son détecteur fait foi, et personne n'est en mesure d'en vérifier la méthode. La preuve est fabriquée par celui qui a intérêt à ce qu'on la croie. Un chercheur indépendant, un éditeur ou un juriste pourraient trancher ; ils n'ont, pour l'instant, rien à examiner.
Dix pour cent de synonymes, et la marque s'efface
Les chiffres d'OpenAI le disent eux-mêmes. Sur des passages longs, 10 % de mots remplacés par des synonymes font tomber la détection d'environ 92 % à 66 %. Avec 25 % de mots modifiés, elle atteint 17 %. Une traduction, un outil de reformulation ou un patchwork de plusieurs sources brouillent la marque. Le code et les mathématiques, où les mots sont contraints, résistent encore moins.
Or presque aucun texte publié reste brut : titres réécrits, transitions, coupes, corrections. Le filigrane aide à analyser un énorme corpus ; il ne permet guère de trancher pour un article précis. Les outils dits d'« humanisation », qui reformulent un texte pour le rendre moins détectable, en ont déjà fait un argument de vente.
Un filigrane dit qu'un texte est passé par un modèle. Il ne dit ni qui l'a commandé, ni ce qu'on en a fait ensuite.
Si l'on publie, que garder dans un tiroir ?
Pour un site, une PME ou un indépendant, l'absence de filigrane ne prouve rien, et sa présence pas davantage. En cas de contestation, ce qui pèse, ce sont les brouillons, l'historique des versions, les noms de celles et ceux qui ont relu, les sources consultées. Un score de détecteur n'est pas un verdict, surtout quand le fournisseur reconnaît lui-même 1 % d'erreurs. Quant à l'aide d'une IA, la dire en toutes lettres reste plus simple que d'espérer qu'on ne la soupçonne pas.
Pour les créateurs, le calcul est moins net. Un filigrane pourrait un jour servir de preuve d'antériorité. Tant que la lecture reste privée, il protège surtout les plateformes.
Qui aura la clé ?
L'AI Act demande que les contenus soient identifiables, pas que la preuve soit publique, et OpenAI, Google et Anthropic s'en tiennent à cette lettre. Les modèles signent leurs textes, les lecteurs ne peuvent pas contrôler la signature, et les auteurs humains restent seuls face au soupçon.
Le 2 décembre, les derniers retardataires devront être en règle. Ouvriront-ils alors leurs détecteurs, ou la Commission se contentera-t-elle de la marque ?