Jusqu'en 2019, une règle tenait sans exception : seuls les humains produisaient du texte à la fois inédit, cohérent et adapté à n'importe quel contexte. Une machine savait trier des nombres, gagner au go (en 2016), repérer un chat sur une photo. Lui demander de raconter une histoire, c'était perdre son temps.
2020 : l'expert d'Oxford donne ses pronostics
Un an après GPT-2, Michael Wooldridge, professeur à Oxford, publie Une brève histoire de l'intelligence artificielle. Il y dresse la liste des tâches « nowhere near solved », c'est-à-dire très loin d'être résolues :
- Comprendre une histoire et répondre à des questions dessus
- Traduire automatiquement au niveau humain
- Interpréter ce qui se passe sur une photographie
- Écrire des histoires intéressantes ; interpréter une œuvre d'art
Il ajoute en introduction : « Aujourd'hui, nous n'avons aucune idée de comment faire en sorte que des ordinateurs réalisent ces tâches. » La même année, Luc Julia soutient encore, Descartes à l'appui, que « le langage est le propre de l'homme », et qu'un assistant vocal capable de converser comme Jarvis, dans Iron Man, relève de la science-fiction. Six ans plus tard, un système fondé sur un LLM (grand modèle de langage) fait presque tout cela chaque jour. Ces tâches n'étaient pas les plus difficiles techniquement. Elles avaient en commun le langage naturel en sortie, et c'est ce qui paraissait infranchissable.
« Nous avons perdu le monopole du langage. » — Monsieur Phi, La parole aux machines
Le philosophe et youtubeur Monsieur Phi, dans une vidéo sur la généalogie des grands modèles de langage, définit ce qui a été perdu. Produire du langage humain, c'est produire des séquences de mots inédites, cohérentes et adaptées à une large diversité de contextes. Avant 2019, les machines n'en réunissaient jamais plus de deux. Un cadavre exquis est inédit mais incohérent. Un traducteur automatique est cohérent mais n'invente rien. Un petit générateur de scénarios de western tient deux critères sur trois, et s'effondre dès qu'on sort du western.
Huit cartes graphiques, cinq jours, 100 Mo de Wikipédia
Pour trouver l'origine, il faut remonter avant GPT-1 (2018). En 2011, Ilya Sutskever, James Martens et Geoffrey Hinton publient « Générer du texte avec des réseaux de neurones récurrents ». Le but affiché est modeste : mieux compresser des fichiers texte. Leur réseau compte 5 millions de paramètres. Il tourne cinq jours sur huit cartes graphiques, et s'entraîne sur 100 Mo de Wikipédia anglophone à une seule tâche : deviner le caractère suivant. Les LLM actuels font exactement le même exercice, mais avec des tokens (des morceaux de mots, comme les syllabes d'un jeu de Scrabble) et sur une échelle sans comparaison.
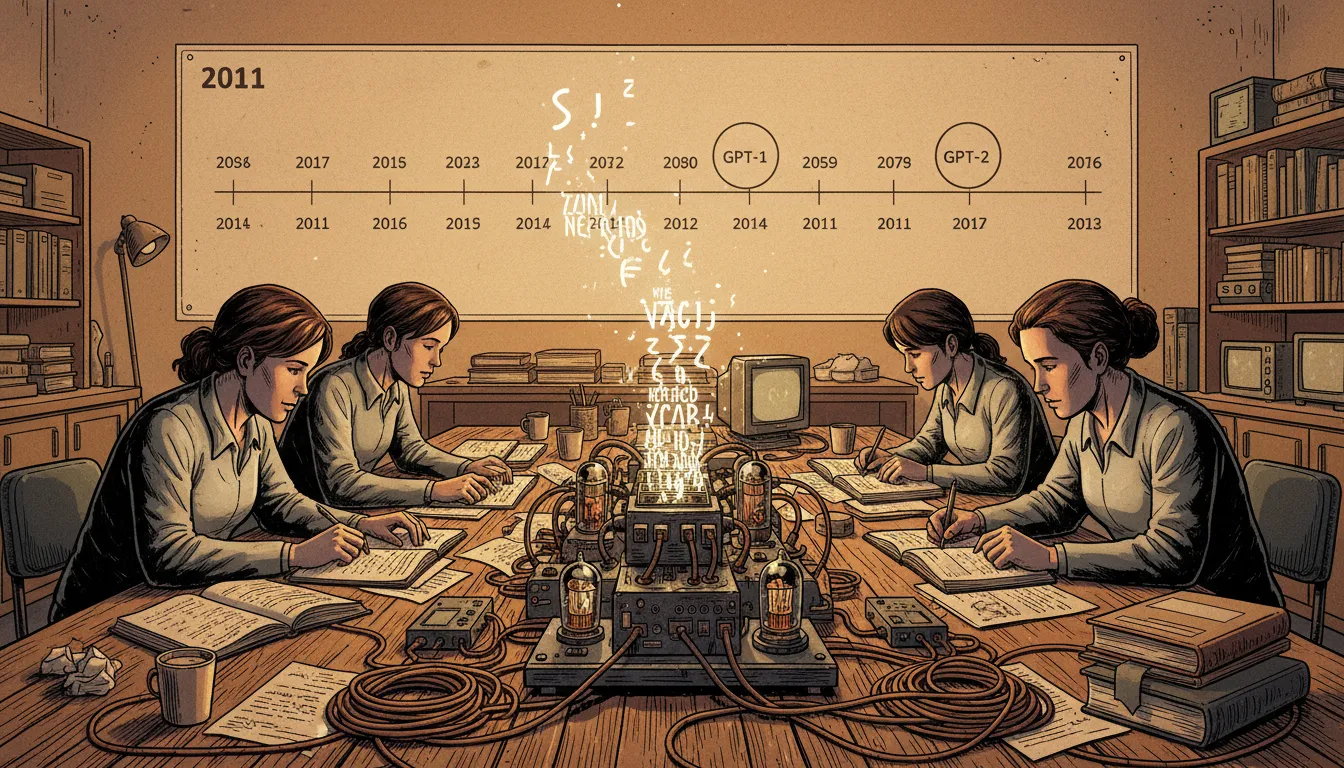
Les auteurs signalent d'ailleurs, dans leur introduction, qu'une compression de texte poussée à sa limite « requiert une compréhension équivalente à de l'intelligence ». Un bon compresseur doit donc comprendre. L'idée circulait déjà, puisque le prix Hutter récompense toujours la meilleure compression d'un extrait de Wikipédia. En relisant la phrase aujourd'hui, on la trouve presque prophétique, mais personne n'a alors imaginé qu'un compresseur de fichiers finirait par écrire des romans.
GPT-2, ou le jour où les paragraphes ont tenu debout
Février 2019 : OpenAI présente GPT-2. C'est le premier modèle qui réunit les trois critères. Ses textes sont fluides sur à peu près n'importe quel sujet, sans que personne ne lui ait fixé de thème. L'entreprise l'annonce en deux temps, en évoquant des risques de « mauvaise utilisation ». Beaucoup y ont vu surtout une opération de communication. Aujourd'hui, ces paragraphes paraissent bancals : une suite d'approximations où un fait contredit parfois le précédent. Il est difficile de se souvenir qu'ils aient pu troubler quiconque, et c'est pourtant le cas.
L'ampleur de la suite est difficile à mesurer. Selon une étude du Pew Research Center publiée à l'été 2026, 35 % des pages web anglophones apparues après le lancement de ChatGPT portent des signes de génération ou d'édition par IA. Le chiffre est à manier avec prudence, car l'échantillon est anglophone et la détection probabiliste. Il suffit toutefois à renverser la situation : lire un texte ne prouve plus qu'un humain l'a écrit. La question n'est plus de savoir si la machine écrit bien. Elle devient celle des moyens de reconnaître, pour un lecteur ou un éditeur, la part de personne qu'un texte contient.
Bender contre Monsieur Phi : le perroquet a-t-il une intention ?
Emily Bender, linguiste, a popularisé en 2021 la formule du « perroquet stochastique » : un modèle recombine des formes sans viser quoi que ce soit. Giada Pistilli, chercheuse en éthique, rappelle de son côté que ces systèmes donnent l'impression de converser sans avoir toutes les propriétés du langage humain. Monsieur Phi leur répond, et sans ménagement : la thèse du perroquet est selon lui « très discutable, si ce n'est erronée ». Pour prédire la suite d'un récit, un modèle doit se faire une esquisse de ce que veulent et savent les personnages, autrement dit une forme de théorie de l'esprit (savoir que quelqu'un d'autre croit des choses). Il juge donc « légitime de parler d'intentionnalité », sans prétendre que la machine ressente quoi que ce soit.
Chacun a raison sur son terrain. Bender a raison sur la conscience : rien n'indique qu'il y ait quelqu'un derrière l'écran. Phi a raison sur l'usage : un modèle qui anticipe ce que veut un personnage fait plus que répéter. Or les conséquences ne sont pas les mêmes. Si le perroquet suffit à décrire ces systèmes, un texte généré reste un simulacre à étiqueter. Si l'intention est une description acceptable, on peut leur confier bien davantage, et il faudra aussi leur en demander compte.
Qui décide de ce qu'on laisse écrire aux machines ?
Le test de Turing, comme Descartes avant lui, supposait qu'une conversation en langage naturel prouvait la pensée. Ce raccourci n'est plus valable, mais rien ne l'a remplacé. On ignore encore si le sens d'un texte tient à la vie, au corps, aux enjeux de celui qui écrit, ou seulement à l'agencement des phrases.
En attendant, le monopole s'est perdu sans que personne ne l'ait décidé, et ce sont les rédactions, les éditeurs de sites et les plateformes qui tranchent désormais au quotidien. Un journal doit-il signaler ce qu'une machine a écrit ? Un moteur de recherche doit-il classer un texte selon son origine ? Un lecteur a-t-il droit à une garantie de signature humaine ? Ces questions se règlent en pratique, article après article, sans qu'aucune règle ne soit fixée.