
Un clic, et la conversation disparaît. L’historique se vide, l’écran redevient propre, le sentiment de contrôle revient. C’est ce que promet le bouton « supprimer ». Ce n’est pas ce qui se passe. Pendant l’échange, le modèle n’a pas seulement lu des phrases : il les a transformées en signaux, en associations, en probabilités. Ce qui reste n’est pas une copie du message. C’est une inflexion.
Il faut distinguer trois couches. L’historique visible, d’abord : celui que l’on supprime, généralement pour de bon. Les journaux et copies de sécurité, ensuite : ils dépendent du fournisseur, de ses durées de conservation et de ses sous-traitants. Les poids du modèle, enfin : c’est là que se joue la partie la plus opaque. Une conversation peut n’y laisser aucune trace verbatim et, malgré tout, modifier la façon dont le système répondra demain.
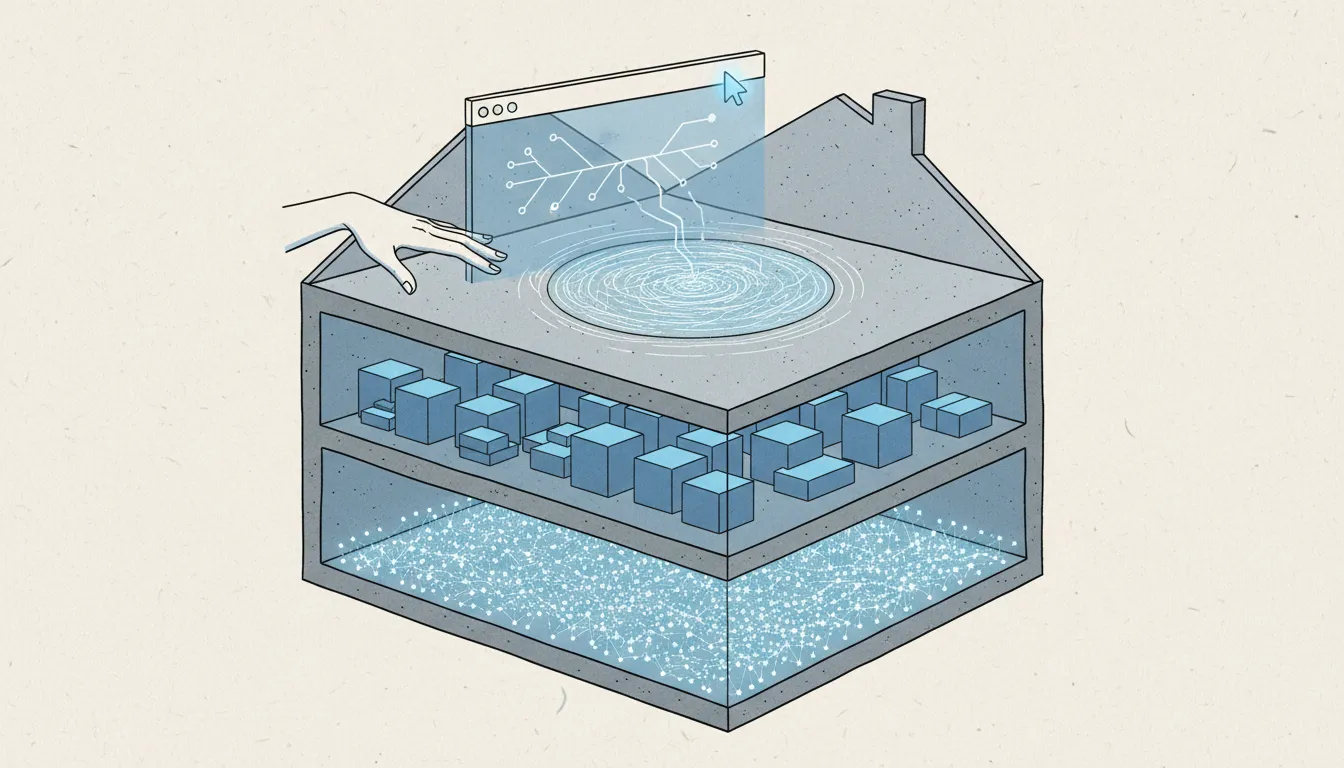
Un bouton qui ne dit pas ce qu’il efface
Les principaux assistants ont ajouté une mémoire persistante : des faits, des préférences, des détails de projet, parfois déduits sans que l’utilisateur les ait explicitement donnés. Cette mémoire-là se supprime, en principe, entrée par entrée. Mais un modèle ne fonctionne pas comme un carnet. Effacer une ligne ne garantit pas que l’inférence qu’elle a permise disparaisse. Une analyse d’IT for Business (12 octobre 2026) le formule sans détour : les règles varient fortement d’un service à l’autre, et effacer une conversation ne suffit pas toujours à remettre les compteurs à zéro.
Le problème n’est pas seulement technique. Il est documentaire. Aucun fournisseur ne publie, pour chaque modèle, la liste de ce qu’il a retenu d’un utilisateur, ni le chemin exact entre une phrase et un changement de comportement. On peut demander la suppression de son compte. On ne peut pas demander la suppression de son influence.
Le droit à l’oubli cherche une adresse
Le droit à l’effacement, inscrit à l’article 17 du RGPD (Règlement général sur la protection des données), a été pensé pour un web de pages. On identifie un contenu, un responsable de traitement, une base légale ; on demande le retrait ; on vérifie. L’arrêt Google Spain, en 2014, en a donné la version la plus célèbre : un moteur de recherche peut être contraint de déréférencer une page, sans que la page disparaisse. Toute la logique repose sur un objet localisable.
Un modèle ne fournit pas cet objet. Ses paramètres ne contiennent pas des phrases rangées dans des tiroirs, mais des régularités statistiques réparties sur des milliards de valeurs. L’EDPB (Comité européen de la protection des données) a tenté d’encadrer le terrain avec son avis 28/2024 : l’anonymat d’un modèle s’apprécie au cas par cas, selon un test en trois étapes ; l’intérêt légitime peut fonder certains entraînements ; un traitement illicite peut, lui, contaminer la licéité du modèle. En 2026, l’EDPB a ouvert une consultation sur des lignes directrices consacrées à l’anonymisation. Le cadre se précise. Il ne dit toujours pas comment retirer une phrase d’un réseau de neurones.
Et l’on bute sur une question de droit classique, devenue vertigineuse : qui est responsable ? Le fournisseur qui entraîne ? Celui qui héberge ? Celui qui adapte le modèle ? Quand le même socle est copié, fine-tuné, redistribué, l’objet à effacer n’a plus de propriétaire clair.
Le droit à l’oubli suppose un lieu. La mémoire des modèles est précisément ce qui n’en a pas.
Des poids, pas des fichiers
Techniquement, l’effacement exact n’existe pas vraiment. La recherche parle d’« unlearning » : on modifie le modèle pour qu’il oublie un contenu, sans le réentraîner entièrement. Les méthodes sont approximatives, coûteuses, parfois instables. Le réentraînement complet coûte des mois de calcul et ne garantit pas qu’une influence résiduelle disparaisse. Une entreprise peut donc supprimer une donnée de sa base et conserver, dans ses poids, l’effet de cette donnée.
Supprimer la trace ne supprime pas l’influence. C’est toute la différence entre un fichier et un réflexe.
Faut-il en conclure que tout est mémoire ? Non. La plupart des conversations ne laissent pas de trace individuelle exploitable : un modèle généralise, il ne récite pas. Les cas de restitution de données d’entraînement existent, mais ils restent minoritaires et dépendent des architectures. Le risque de pensée magique est réel : voir un souvenir personnel derrière chaque réponse relève souvent de l’illusion. Le problème commence quand la mémoire est explicitement construite — profils, préférences, résumés de conversations — et que l’on ne sait plus ce qui a été déduit de quoi.
L’erreur symétrique : croire que rien ne se supprime
Deux illusions se répondent. La première consiste à croire que le bouton suffit. La seconde, à conclure que rien ne sert à rien. Les deux évitent la seule question utile : que peut-on raisonnablement exiger, et à quel niveau ?
À l’échelle d’un site ou d’une petite structure, quelques principes tiennent encore. Ne pas confier à un assistant ce qu’on ne confierait pas à un prestataire : données de santé, dossiers juridiques, identifiants, informations clients. Vérifier ce que le service fait des échanges : entraînement sur les données, durée de conservation, localisation, sous-traitants. Préférer des offres contractuelles sans entraînement, ou des modèles locaux quand le volume et la sensibilité le justifient. Garder une trace de ce qui a été envoyé, parce qu’une suppression future supposera de savoir quoi supprimer.
Pour un site qui intègre un chatbot, la même logique s’applique, en plus visible. Une mention « vos données sont confidentielles » ne vaut pas politique de conservation. Il faut dire ce qui est stocké, combien de temps, pour quel usage, et comment la suppression est effectuée — y compris chez les sous-traitants. « Nous ne conservons rien » est une affirmation, pas un réglage.
La mémoire sans propriétaire
Reste la question de fond, qui n’est pas technique. La mémoire des modèles est partout et nulle part : dans les poids, les journaux, les mémoires d’assistant, les copies intermédiaires. Les utilisateurs, eux, n’ont accès qu’à une interface. Cette asymétrie n’est pas accidentelle ; elle est le produit d’un modèle économique qui vend de la continuité et documente peu.
Le consentement ponctuel, clic après clic, ne gouverne pas des inférences durables. Un utilisateur peut accepter un traitement en 2024 et découvrir en 2026 qu’un profil de ses habitudes a été construit, conservé, revendu ou réutilisé. Le droit à l’oubli individuel devient alors un droit à l’explication de la mémoire : que sait le système, qu’a-t-il déduit, que peut-il réellement effacer ? La question n’est pas rhétorique. Elle détermine qui peut contester une décision, un refus, un ciblage.
Certains y verront une raison de brider l’IA. D’autres, une raison de la documenter. Les deux camps ont tort de traiter le sujet comme un choix binaire. Une mémoire sans adresse n’est pas une mémoire sans responsabilité. Encore faut-il définir qui répond, et selon quelles preuves.
Ce qu’il reste à exiger
À court terme, trois exigences paraissent minimales. Transparence sur les données utilisées pour l’entraînement et sur la mémoire persistante. Droit de retrait réel, avec un délai et une preuve, pas une simple case à cocher. Auditabilité : des tiers capables de vérifier qu’une suppression a eu lieu, sans avoir à croire le fournisseur sur parole.
Le reste est une incertitude qu’il faut assumer. On ne sait pas mesurer sérieusement l’effet d’une conversation unique sur un modèle de plusieurs milliards de paramètres. On ne sait pas ce qu’un « oubli » partiel laisse dans les associations. On ne sait pas non plus quelle part de la mémoire est réellement individuelle, et quelle part n’est qu’une moyenne statistique. Ces questions ne sont pas des détails techniques : elles décident de ce que le droit peut promettre.
En attendant, une phrase à garder en tête avant d’ouvrir une conversation : ce n’est pas un journal intime, c’est un service. Et un service retient parfois plus que ce qu’on lui a donné. La bonne question n’est donc pas « est-ce que ça s’efface ? », mais « qu’est-ce qui reste, et qui peut le dire ? »