Un mardi matin, quelqu'un demande à un assistant de rendre un mail « moins sec, mais pas trop aimable ». La réponse arrive en trois secondes, et personne ne lève les yeux de l'écran. Or en 1950, Alan Turing posait la question autrement : si un humain converse par écrit avec une machine sans pouvoir la distinguer d'une personne, alors on peut dire qu'elle « pense ». L'épreuve est restée théorique pendant trois quarts de siècle. Elle a été passée en 2025, dans une étude de la PNAS (Proceedings of the National Academy of Sciences). Le monde a continué à rédiger ses mails.
Un test de Turing gagné, et personne n'applaudit
Les chercheurs de l'UC San Diego (Université de Californie à San Diego) ont monté un test « à trois ». Un interrogateur discute par écrit, pendant cinq minutes, avec un humain et avec un modèle de langage de grande taille (LLM) sans savoir lequel est lequel. Il doit désigner l'humain. GPT-4.5 a été choisi dans 73 % des cas, plus souvent que les vrais humains, alors qu'il avait reçu la consigne d'imiter une personne. LLaMA-3.1 plafonne à 56 %.
Les anciens systèmes, eux, décrochent : ELIZA et GPT-4o ne convainquent que 21 à 23 % des interrogateurs. Ce qui fait gagner les modèles n'est pas leur savoir. Ils imitent nos approximations : une hésitation, une faute, un ton familier. Le protocole a ses limites (cinq minutes, une consigne sur mesure, des interrogateurs qui ne sont pas des experts). Il dit pourtant quelque chose d'inconfortable. Ce qu'on prend pour de l'intelligence, c'est souvent de l'aisance, et les humains jugent un interlocuteur à son ton bien avant de juger son savoir.
Sept cents millions de personnes, une recette et un mail
Que fait-on de cet exploit ? Une étude d'OpenAI de septembre 2025, menée avec l'économiste David Deming sur 1,5 million de conversations, répond sans emphase : environ 700 millions de personnes utilisent ChatGPT chaque semaine, surtout pour du conseil pratique, de la recherche d'information et de la rédaction, soit trois quarts des échanges. Le reste se partage entre « demander » (49 %), « faire » (40 %) et « s'exprimer » (11 %).
Autre chiffre, d'une autre nature : environ 30 % des usages sont professionnels, donc 70 % personnels. Les deux séries se recoupent, puisque l'une classe les sujets et l'autre le contexte. Elles disent la même chose : on s'en sert d'abord pour la vie ordinaire. Un détail pèse sur la lecture : OpenAI mesure ses propres utilisateurs, avec ses propres catégories. C'est une photographie utile, pas un audit indépendant.
Je n'avais pas réalisé que des expositions extrêmement brèves à un programme relativement simple pouvaient induire de puissantes pensées délirantes chez des gens tout à fait normaux. — Joseph Weizenbaum, Computer Power and Human Reason, 1976 (traduction libre)
ELIZA, la secrétaire et le programme qui ne comprenait rien
Ce vertige-là n'est pas neuf. En 1966, Joseph Weizenbaum écrit au MIT (Massachusetts Institute of Technology) ELIZA, un programme qui se contente de retourner les phrases selon des règles. Il n'y a aucune compréhension derrière. Sa secrétaire, pourtant, qui avait vu le programme se construire, lui demande un jour de quitter la pièce pour rester seule avec lui. Des utilisateurs se confient comme à un thérapeute. Troublé, Weizenbaum finira par publier un livre d'avertissement.
Soixante ans plus tard, le réflexe est intact. Il ne dit presque rien de la puissance des machines, mais beaucoup de notre pente à prêter une intention à tout ce qui nous répond avec des phrases. Les modèles actuels sont infiniment plus performants qu'ELIZA, et le piège n'a pas changé.
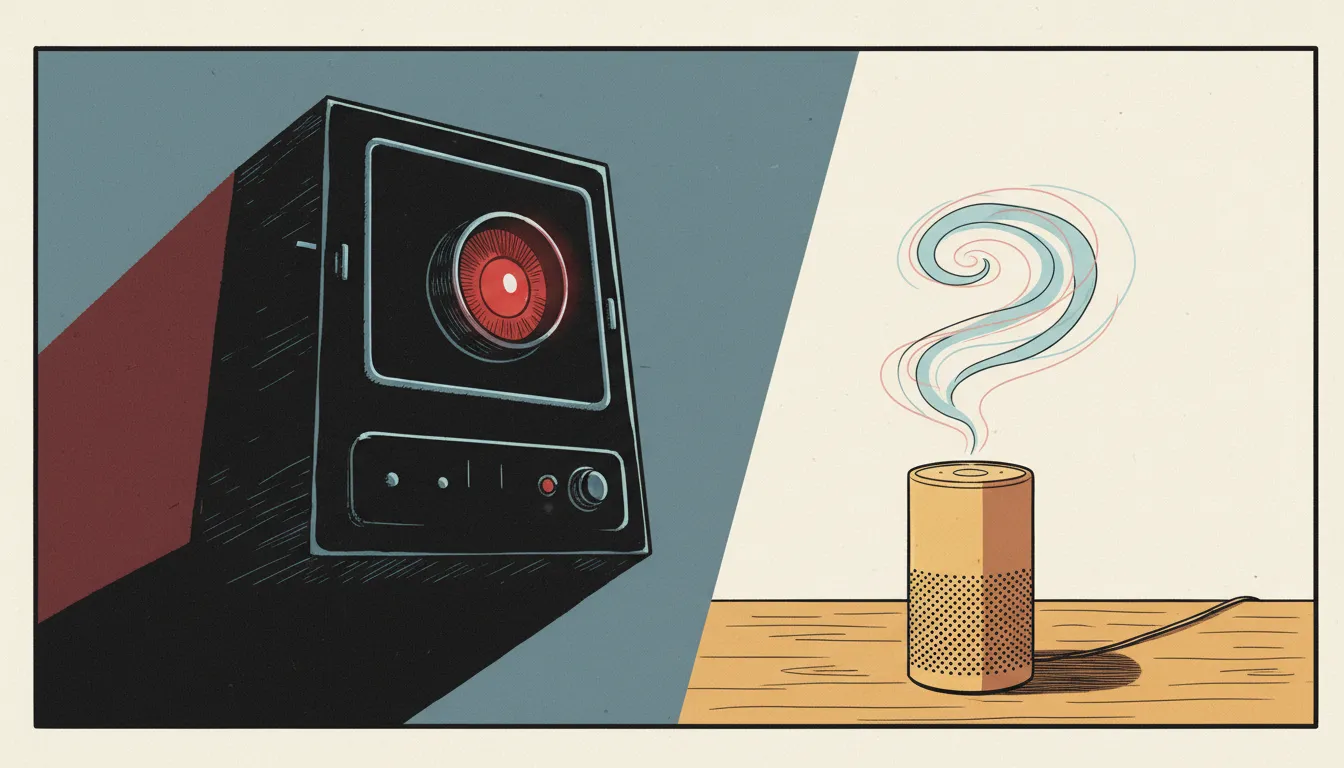
Reste l'impression de déception. Elle vient en grande partie de la science-fiction. De HAL dans 2001 : l'odyssée de l'espace à Her, la machine parlante était une menace ou une amoureuse, jamais un correcteur d'orthographe qui s'excuse. Le réel a livré un assistant poli, souvent utile, parfois faux, toujours prêt à reformuler. Le public attendait un personnage de film et a reçu un outil de bureau.
Quand la fenêtre de discussion remplace le menu
Le vrai changement se joue pourtant à cet endroit. Pendant des décennies, il fallait apprendre la langue de la machine : lignes de commande, menus, formulaires, syntaxe. Aujourd'hui, la langue maternelle suffit pour une première requête. Le clavier n'a pas disparu, mais l'apprentissage préalable, lui, a presque disparu. Qui sait décrire un problème en deux phrases peut obtenir un tableau, un script ou un plan de page.
Une réponse fluide n'est pas une réponse juste.
Le revers est connu de quiconque a demandé un réglage précis à un assistant. Une réponse sur la balise canonique d'un site ou sur l'option d'un CMS (système de gestion de contenu) sort sûre d'elle, avec le bon vocabulaire, et cite un menu qui n'existe pas dans la version utilisée. À New York, en 2023, des avocats ont soumis à un tribunal des jurisprudences inventées par ChatGPT : le ton était juste, les affaires n'existaient pas. Avant de confier un site ou un process à un assistant, un test simple : lui demander la source, puis aller la lire.
L'indifférence, une maturité ? Plutôt un angle mort
Faut-il regretter que l'étonnement soit passé ? Pas vraiment. Un outil qui s'installe sans cérémonie, c'est souvent un outil qui a trouvé sa place, et personne ne s'émerveille plus devant un moteur de recherche. Sur ce point, la banalisation ressemble à de la maturité.
Mais elle a un prix, et c'est là que le journal tranche : l'habitude est en train d'effacer le réflexe de contrôle. Plus la machine parle comme nous, moins on la relit comme on relirait un inconnu. Les effets sur la manière de chercher, d'écrire ou d'apprendre sont trop récents pour être mesurés, et on ne sait pas encore ce qu'ils donneront. Une chose se constate déjà : la fluidité a gagné le test de Turing. La vérification, elle, reste à la charge de l'utilisateur.